Uptime is not a metric.
It’s an architecture.
On-demand reliability leadership for production systems at scale. SLOs, observability, and incident readiness—delivered with Staff-level authority.
Services
Staff-Level Reliability Engagements.
Strategic Reliability Audit
- Production risk mapping
- Architecture review
- SLO health evaluation
- Failure scenario exposure
- Blueprint summary
Architecture Deep Dive
- Multi-region strategy
- Infrastructure redesign
- Infra-as-code hardening
- Cost-performance alignment
- Reliability guardrails
Ongoing Reliability Partner
- Fractional Staff SRE
- Incident advisory
- Engineering roadmap
- Reliability culture
- SLO governance
Enterprise Experience.
Architecture Stack.
Cloud • Data • Observability • Delivery
Labs & Demos.
SRE demo • observability demo • incident response simulation • multi-region failover
Multi-Region Failover Drill
Traffic shifting, health checks, rollback paths, and failure-mode rehearsals—built like production.
- Regional outage simulation
- Traffic dial + recovery plan
- Blast radius controls
Observability Stack
Golden signals, SLO dashboards, and alert tuning. Designed to reduce noise and increase signal.
- Prometheus/Grafana dashboards
- SLO + error budget framing
- Alert fatigue reduction
Incident GameDay (SEV)
Realistic incident response simulation: triage, comms, timeline, and action items that stick.
- On-call workflow & roles
- Timeline + comms template
- Corrective actions & prevention
Reliability Lab Architecture
This lab simulates real-world reliability scenarios including regional outages, traffic failover, observability and incident response workflows.
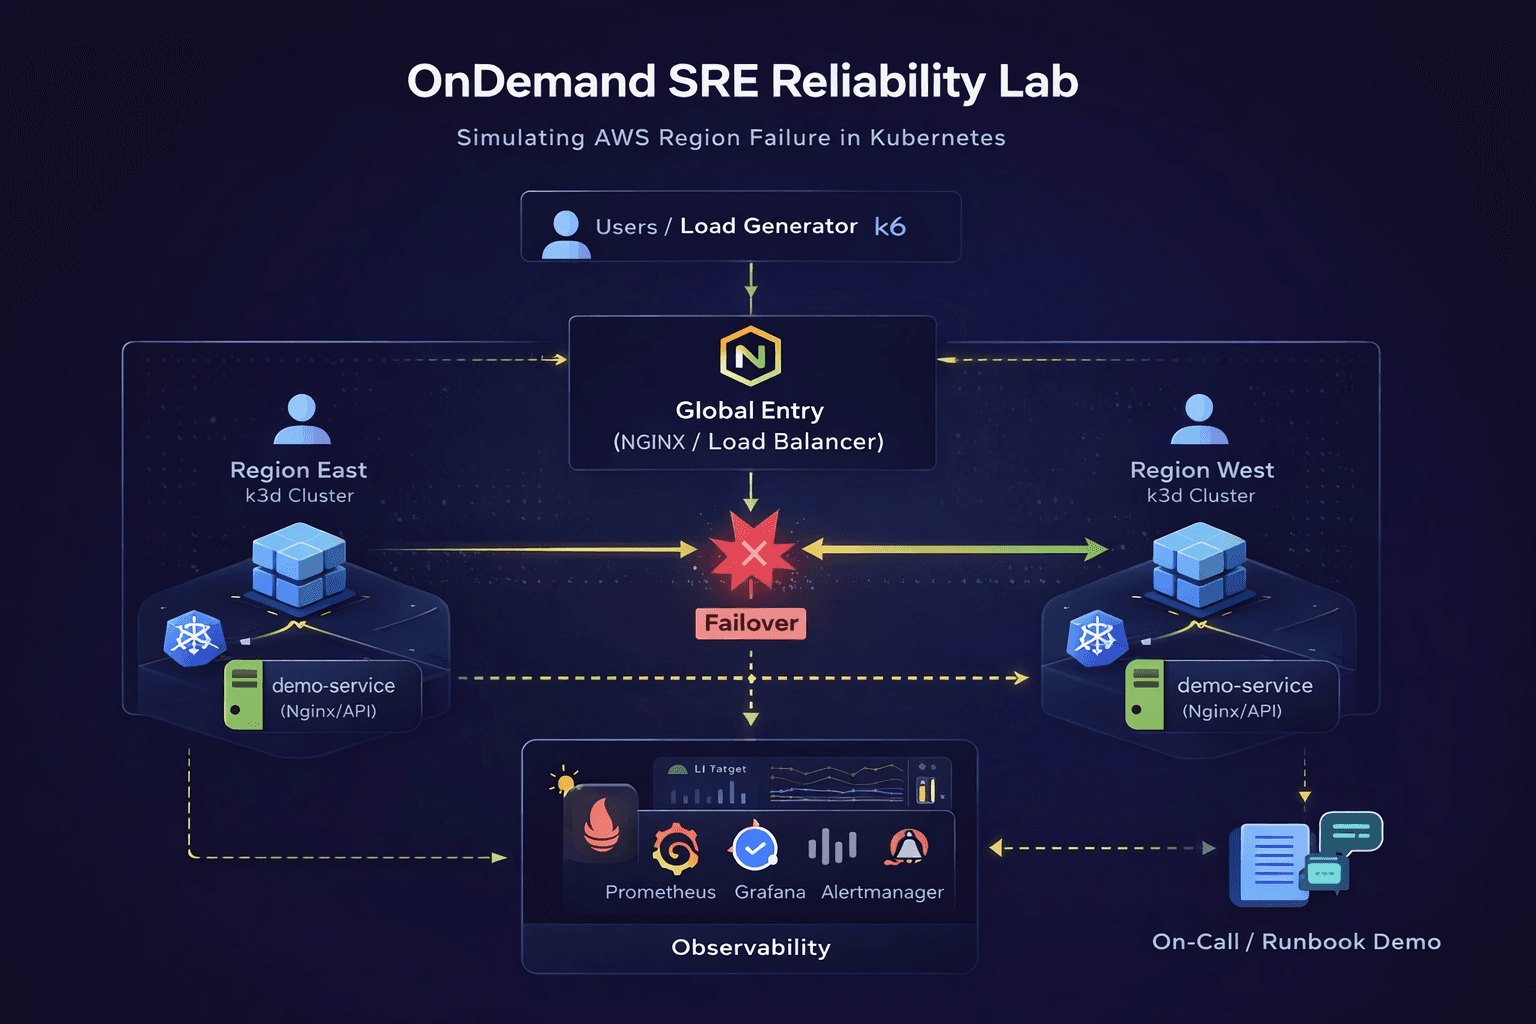
Lab Stack
- • Kubernetes (k3d clusters)
- • Prometheus + Grafana
- • Alertmanager
- • k6 Load Testing
- • Chaos failure simulation
- • Multi-region traffic routing
Engagement Model.
Intro Call
30 Minutes
System Assessment
Technical Audit
Architecture Proposal
Strategic Blueprint
Execution & Oversight
Direct Implementation
Quiet Authority.
Designing and scaling mission-critical platforms at global scale. Direct technical pipeline to high-availability architecture and sustainable engineering culture.
- 20+ Years Infrastructure
- Enterprise Global Scale
- Multi-Region Architecture
- AWS / GCP / OCI
- Kafka / DynamoDB / Couchbase
- Reliability Culture